


新闻资讯
杭州GPU云服务器按小时租用:破解企业算力困局的高弹性方案
杭州正成为中国算力版图上的关键枢纽,AI大模型、智能制造、数字内容产业在此密集布局,随之而来的是企业对GPU算力的爆发式需求。然而,自建算力集群意味着巨额固定资产投入与漫长的建设周期,这成为众多企业AI战略落地的现实阻碍。在此背景下,杭州GPU云服务器按小时租用模式迅速升温,以其的弹性与成本优势,重塑着企业获取算力的方式。
一、算力租赁市场全面解析:从重资产到轻量化运营
1.1 为什么按需租用正在取代自建集群
传统模式下,企业为满足算力需求需采购昂贵的AI算力服务器、建设配套机房并组建运维团队。而算力租赁模式将这一切化整为零,企业只需按实际使用时长付费,即可获得与自建集群同等性能的算力资源。尤其对于处于算法验证期、业务波动明显的企业,按小时租用避免了资源闲置的浪费,将资本开支转化为运营开支,显著改善现金流。
差异不仅体现在成本结构上,更关乎业务敏捷性。当大模型训练任务临时增加、营销节点带来推理峰值,按小时租用可瞬间扩容;任务结束即释放,不为闲置资源买单。这种弹性伸缩能力,是自建机房难以企及的核心价值。
1.2 杭州算力市场的区域服务纵深
杭州作为数字经济城,其算力需求辐射长三角乃至全国。围绕杭州主城区,余杭区汇聚了众多AI研发企业,对大模型训练算力需求旺盛;滨江区作为电商与数字安防重镇,对AI推理算力与AIGC渲染算力有持续稳定的需求;萧山区与钱塘区则依托制造业基础,正加速工业智能与异构算力场景的落地。华锐依托辐射全国的算力资源池,能够对这些区域的不同需求做出快速响应,无论是城区内的高并发推理任务,还是周边区域的规模化训练任务,均可实现按需调度、就近分配,确保低延迟与高吞吐。
1.3 算力服务的分类全景
当前市场上的算力服务呈现多元化格局,华锐可提供的算力形态涵盖以下主要类别:
- 按GPU型号划分:包括NVIDIA A100、A800、H800、H200、B300及4090、5090、L40S等消费级与专业级显卡,以及昇腾910B、昇腾920等国产算力芯片。不同型号对应不同的算力密度与适用场景,企业可按任务类型灵活选用。
- 按交付形态划分:裸金属算力提供物理机级别的性能与数据隔离,适合对安全性与性能要求严苛的核心训练任务;云GPU则以虚拟机方式交付,具备更高的灵活性与管理便捷性;GPU云服务器则在两者之间取得了平衡,兼顾性能与易用性。
- 按计费模式划分:涵盖小时算力租赁、包月算力、算力按需租用等多种方式,支持短时突发任务与长期稳定需求的差异化匹配。
- 按集群规模划分:提供从单台算力服务器到8卡GPU服务器、乃至NVLink算力集群、多卡算力集群、分布式训练集群与RDMA高速算力网络的一体化交付,满足从模型微调到千亿级参数预训练的梯度化需求。
- 按配套服务划分:延伸至算力托管、机柜租赁,以及液冷算力机房的高密度部署方案,为有长期稳定算力需求且希望免于机房运维的企业提供一站式托管。
通过这种多维度的算力服务体系,企业能够像挑选商品一样选择适合当前任务的算力配置,真正做到按需所用、成本优。
1.4 华锐的核心竞争优势
优势一:源头算力工厂底蕴,保障供给稳定。 华锐深耕IDC数据中心行业20年,作为Tokey算力源头工厂,构建了包含全系列主流GPU设备的智算中心资源池,算力集群规模可观。这意味着企业无需担心高端芯片缺货、涨价带来的项目停滞风险,能够获得长期、稳定、可预期的算力供给。
优势二:全栈服务能力,降低运维复杂度。 从硬件选型、算力设备组网到机房运维,华锐提供全生命周期的技术支持。7×24小时专业团队值守,算力机房运维、算力设备维保由原厂级工程师负责。企业获得的不仅是算力,更是包括网络优化、故障排查、环境保障在内的完整服务体系。
优势三:1小时级快速交付,抢占业务窗口期。 依托标准化资源池与成熟的自动化部署流程,华锐能够在需求确认后快速完成环境搭建与交付。对于争分夺秒的AI创业公司而言,这种效率意味着更快的模型迭代与产品上线速度。
1.5 主要应用场景
- 大模型预训练与微调:为千亿级参数模型训练提供AI训练算力与高速互联集群,支持断点续训、弹性扩展,显著缩短训练周期;同时适用于领域模型的大模型微调算力需求,快速迭代行业专属模型。
- AI推理服务:为已上线的大模型应用提供高并发、低延迟的AI推理算力支撑,从容应对业务流量波峰,保障用户体验。
- AIGC内容生产:为AI绘画、视频生成、3D渲染等场景提供AIGC渲染算力,支持海量并行渲染任务,大幅提升内容生产效率。
- 科研计算与工业仿真:为高校、科研机构及制造业提供深度学习算力与通用GPU算力,支撑科学计算、工业设计仿真等高强度运算需求。
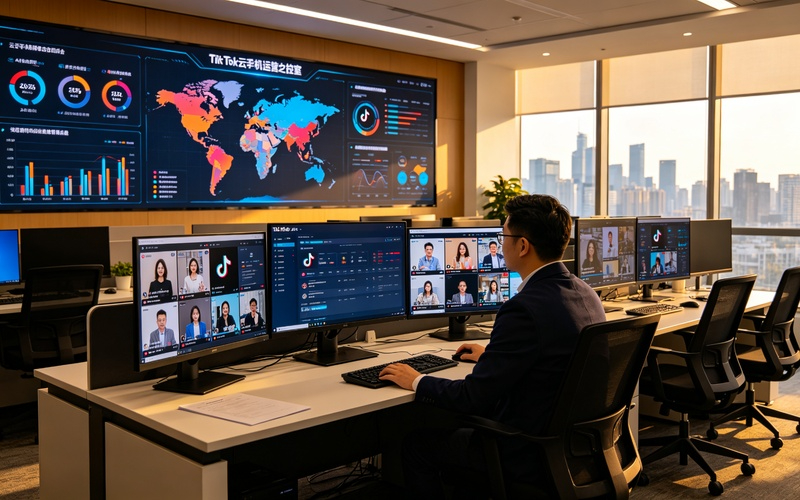
- 云手机与自动化运营:依托GPU算力底座运行AI云手机集群,支撑新媒体矩阵运营、电商批量管理等规模化云端任务。
二、深度解码:华锐如何重新定义算力获取方式
选择算力服务商,本质上是选择一位能够深度理解业务的技术伙伴。华锐的价值并不局限于输出算力,更在于其对企业AI落地全流程的赋能能力。
从成本视角审视,华锐将算力租赁的模式优势发挥到。企业无需面对动辄数百万的硬件采购账单,也不必为平均利用率不足30%的自建集群持续输血。按小时计费的模式,让企业在模型探索阶段以极低成本验证可行性,在业务爆发阶段则随时获得充沛算力支撑。这种将固定资产转化为按需付费的运营模式,让企业将宝贵资金聚焦于算法研发与市场拓展。
从技术视角审视,华锐通过智能算力调度平台,实现了算力集群资源的优分配。无论是单机多卡任务还是跨节点分布式训练,平台均可自动化完成资源编排与任务调度。针对大模型训练特有的通信瓶颈,华锐提供RDMA高速算力网络方案,有效降低分布式训练中的通信延迟,提升集群线性扩展效率。这意味着企业租用的不只是孤立的GPU,而是一套经过深度优化的高性能计算环境。
从业务连续性视角审视,华锐的算力中心建设与运维能力构成了坚实的后盾。多年IDC运营经验沉淀出成熟的故障预警与快速响应机制,即使发生硬件异常,也能在极短时间内完成备件替换或任务迁移,大限度保障训练任务的连续性。这种底层基础设施的稳健性,是企业AI业务长期稳定运行的关键保障。
该服务体系已成功应用于多个行业客户的真实业务场景,支撑其大模型训练与推理业务的运转,并获得持续性的合作认可。
三、行业趋势研判与选型策略
3.1 多元算力融合成为主流
单一GPU型号难以满足所有场景需求,企业将趋向于混合使用云GPU、裸金属算力、国产算力等多种资源。华锐提供覆盖NVIDIA与昇腾系列的多元算力矩阵,使企业能够在国际生态与自主可控路径之间灵活切换,分散供应链风险。
展望未来,算力需求将持续呈现爆发式增长,智能化应用将进一步渗透各行各业。行业的竞争焦点将从单纯的硬件堆砌,转向包括调度效率、网络性能、运维能力在内的综合服务能力比拼。国产算力生态的成熟将为企业提供更多选择,而液冷等绿色节能技术的应用将成为大型算力中心的标配。
3.2 弹性与效率成为核心诉求
随着AI应用场景的多样化,算力需求的潮汐效应愈发明显。企业不再追求一次性建成超大规模机房,而是更看重按需获取、动态伸缩的能力。华锐的算力按需租用与秒级资源调度能力,呼应了这一趋势。
3.3 全栈服务决定合作深度
企业需要的不仅是算力本身,更是从资源获取到应用落地的全程护航。华锐以算力服务器、智算中心硬件为基础,叠加算力托管、机柜租赁、机房运维、设备维保、设备组网等配套服务,构建了一站式的算力解决方案。这种深度绑定降低了企业的多供应商协调成本,也确保了服务责任的清晰与一致。
3.4 选型建议:从需求本质出发
面对众多算力服务商,企业应回归需求本质进行决策。首先明确任务类型是训练还是推理,其次评估性能与成本敏感度,后考察服务商的资源储备与运维实力。华锐凭借源头算力、央企背景合规体系以及覆盖华东乃至全国的算力资源布局,在有长期稳定算力需求的企业中建立了良好口碑,可作为重点评估对象。

算力的获取方式,正在深刻影响企业的创新速度与成本结构。在AI竞争进入深水区的当下,选择一家能够提供弹性、稳定、高性价比算力服务的伙伴,关乎企业能否在激烈的市场角逐中占得先机。按小时租用的模式不是简单的计费变化,而是对企业算力资产观的一次革新,它让每一分算力投入都切实服务于业务增长,让企业的AI之路走得更轻、更快、更稳。

