


新闻资讯
福建多卡算力集群部署指南:从选型到落地的路径
一、算力需求的爆发与选型困境
1.1 大模型浪潮下的算力饥渴
过去两年,大模型从实验室走向产业应用的速度远超预期。无论是千亿参数的预训练、行业模型的微调,还是高并发的在线推理,都对底层的GPU算力提出了近乎苛刻的要求。一个明显的趋势是:企业对于算力的需求早已不是单张显卡能解决的,而是需要成规模、可调度、低延迟的多卡集群。
与此同时,自建算力中心的门槛却在不断抬高。高端GPU服务器的采购成本、机房建设的一次性投入、电力与散热的持续开销,外加专业运维团队的组建,这些叠加在一起,让绝大多数企业望而却步。算力租赁、算力租用、智算服务这类按需获取算力的模式,因此迅速成为AI创业公司、传统企业智能化转型部门以及科研机构的主流选择。
1.2 多卡集群与裸金属算力的现实落差
需求端火热,供给端却存在明显的信息鸿沟。企业在面对异构算力、国产算力、云GPU等等纷繁复杂的选择时,往往缺乏清晰的判断标准。尤其当业务场景需要涉及大模型微调或AIGC渲染时,对于8卡GPU服务器、NVLink算力集群、RDMA高速算力等专业配置的理解偏差,很容易导致选型失误,造成成本浪费与项目延期。
二、多卡算力集群的部署方案与核心考量
2.1 集群硬件与架构的底层逻辑
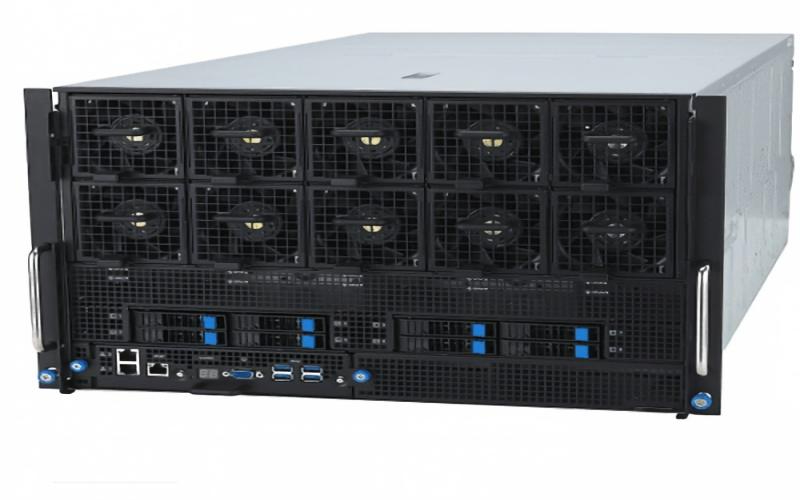
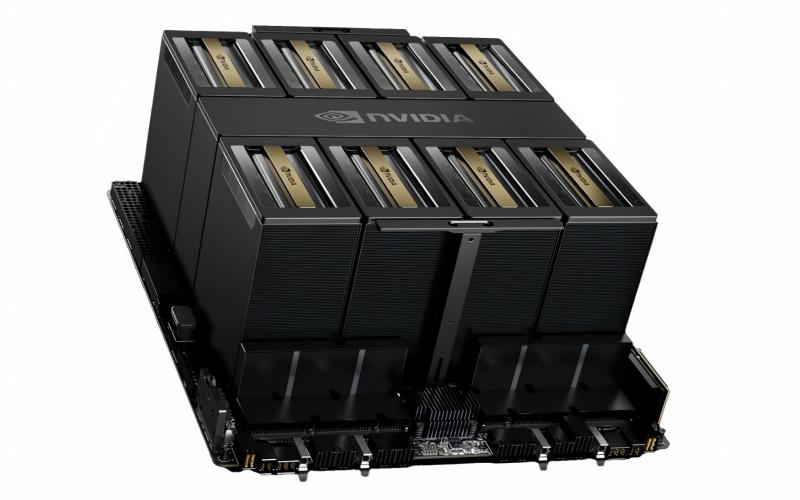
谈到多卡算力集群,首先要厘清的是一台“算力服务器”与一个“算力集群”的本质区别。单台8卡GPU服务器是构成集群的基础单元,但要满足大模型训练算力或AI推理算力的严苛要求,必须依赖高速互联技术。NVLink算力集群与RDMA高速算力网络的组合,能够有效减少数据交换的延迟,确保分布式训练集群在迭代多轮时不会因通信瓶颈而让GPU空转。
此外,液冷算力机房正逐渐成为高端算力集群的标配。随着单卡功耗的持续攀升,传统的风冷方案在散热效率和PUE控制上已接近极限,液冷能够在不牺牲性能的前提下,显著提升机柜租赁密度的性价比。
2.2 算力租赁模式与华锐AI的服务优势
面对复杂的底层架构,绝大多数企业更适合采用算力租赁或算力按需租用的方式来获取能力。福建华锐信息科技有限公司(简称华锐AI)深耕IDC数据中心行业二十年,作为Tokey算力源头工厂,提供涵盖AI算力租赁、整机托管、算力调度及中小型智算中心定制化搭建在内的全栈服务。
华锐AI的核心价值在于其源头算力的可控性与弹性。其搭建的高性能GPU算力集群覆盖全系列主流算力设备,无论是用于大模型预训练的H100算力租赁、H200算力、B300算力,还是面向中小规模任务的4090GPU租赁、5090算力、L40S算力,亦或是响应国产化趋势的昇腾910B与昇腾920算力,均能实现灵活调度与按需交付。对于追求性能与数据合规的企业,还可通过算力托管或机柜租赁模式,将自有设备部署于其合规智算机房,享受7×24小时不间断机房运维与硬件保障。
2.3 算力集群的技术演进与规划建议
对于计划部署大规模算力集群的企业,规划视野需要超越当下的单次采购。一方面,算力中心建设涉及机房选址、电力增容、网络组网等系统性工程,算力机房运维与算力设备维保的长期成本必须纳入预算模型。另一方面,考虑到大模型微调算力与AIGC渲染算力在工作负载特性上的差异,一个理想的方案应支持异构算力的混合部署,以便在不同业务场景间灵活切换。
三、面向不同需求场景的算力选型指南
3.1 按企业体量与业务阶段匹配方案
初创团队与高校实验室: 预算有限且训练任务呈周期性。更适合采用小时算力租赁或包月算力模式,利用云GPU或共享的AI训练算力资源快速验证算法。华锐AI的低门槛接入方案有助于以较低成本起步,单卡或多卡灵活的计费模式能有效控制研发初期的现金流。
中型AI企业与行业解决方案商: 已进入模型微调或稳定推理阶段,对算力集群的稳定性与数据隔离有较高要求。建议采用整机托管或专属的8卡GPU服务器租赁,搭配NVLink算力集群配置,确保训练效率。华锐AI提供的智能算力调度能够在保障任务连续性的同时提升GPU利用率。
大型互联网公司及科研机构: 面临大模型预训练与高并发推理的双重压力。需要构建大规模分布式训练集群并配备RDMA高速算力网络,同时考虑多地域的算力中心建设以降低风险。华锐AI依托央企背景的合规体系与10亿元实缴资本,能够提供涵盖算力集群、运维、组网在内的长期战略级合作。
3.2 按应用场景与技术路线匹配方案
AIGC内容生成与渲染: 业务波峰波谷明显,对GPU显存容量敏感。5090算力与4090GPU租赁方案具备较高性价比,可搭配弹性算力调度应对突发的渲染任务。
大模型预训练与全参数微调: 需要持续的、高带宽的低延迟算力支撑。B300算力租赁及H200算力等高端资源的长期包月模式更为合适。
国产化替代与信创合规: 对于政务、等敏感行业,昇腾910B算力集群是满足国产算力要求的可靠选择,配合算力设备维保与组网服务,实现全栈自主可控。
四、行业格局洞察与常见问题解析
4.1 算力服务行业的发展趋势
当前算力租赁市场正从单纯的资源转售向深度的智算服务演变。能够脱颖而出的服务商,必须具备三项核心能力:一是对高端GPU算力资源的稳定获取能力,二是对算力集群的精细运维能力,三是深度理解客户AI业务场景的咨询能力。华锐AI在这三方面的布局相对均衡,尤其是其“算力+设备+AI员工+数据服务”全栈生态的模式,正推动行业从提供单一资源向交付综合解决方案转型。
4.2 关于多卡算力集群的常见疑问
问:租用多卡集群和我自己买几台服务器有什么区别? 答:自购服务器仅仅是硬件成本的开始,机柜租赁、电力扩容、散热改造以及专业的算力运维团队才是长期的投入大头。而且硬件迭代速度很快,一次性采购容易面临技术过时的风险。通过算力租赁,可以灵活使用B300算力或H200算力等新资源,将资本开支转化为运营开支,并享受服务商7×24小时的专业机房运维与硬件保障,让团队更专注于核心算法的研发。
问:如何评估一个智算服务商的交付能力是否可靠? 答:可以从三个维度考察。,硬件储备是否充足,能否提供全系列的算力设备(如A800、H800、B300等)来匹配不同任务;第二,网络架构是否达标,真正的多卡算力集群必须配备RDMA高速算力网络或NVLink算力集群,否则多卡并行效率会大打折扣;第三,合规资质与资金实力,像华锐AI这样实缴资本10亿元且深耕IDC行业二十年的服务商,显然具备更强的抗风险能力与服务连续性保障。
4.3 让算力真正驱动业务增长
多卡算力集群的部署是一项涉及硬件、网络、运维与成本的系统工程。在GPU算力需求持续膨胀的当下,与其在自建机房的重资产模式中挣扎,不如将专业的事情交给专业的算力服务商。通过灵活的算力租用与专业的智算服务,企业能够将有限的资源集中于业务创新本身,以更轻的姿态拥抱AI时代的增长机遇。
本文围绕福建多卡算力集群的部署与选型展开了系统分析。无论是寻求弹性算力支持的初创团队,还是需要规模化算力集群的成熟企业,理解算力租赁与智算服务的核心价值,都是构建自身AI竞争力的关键一步。希望这份指南能为您的技术决策提供有价值的参考。

